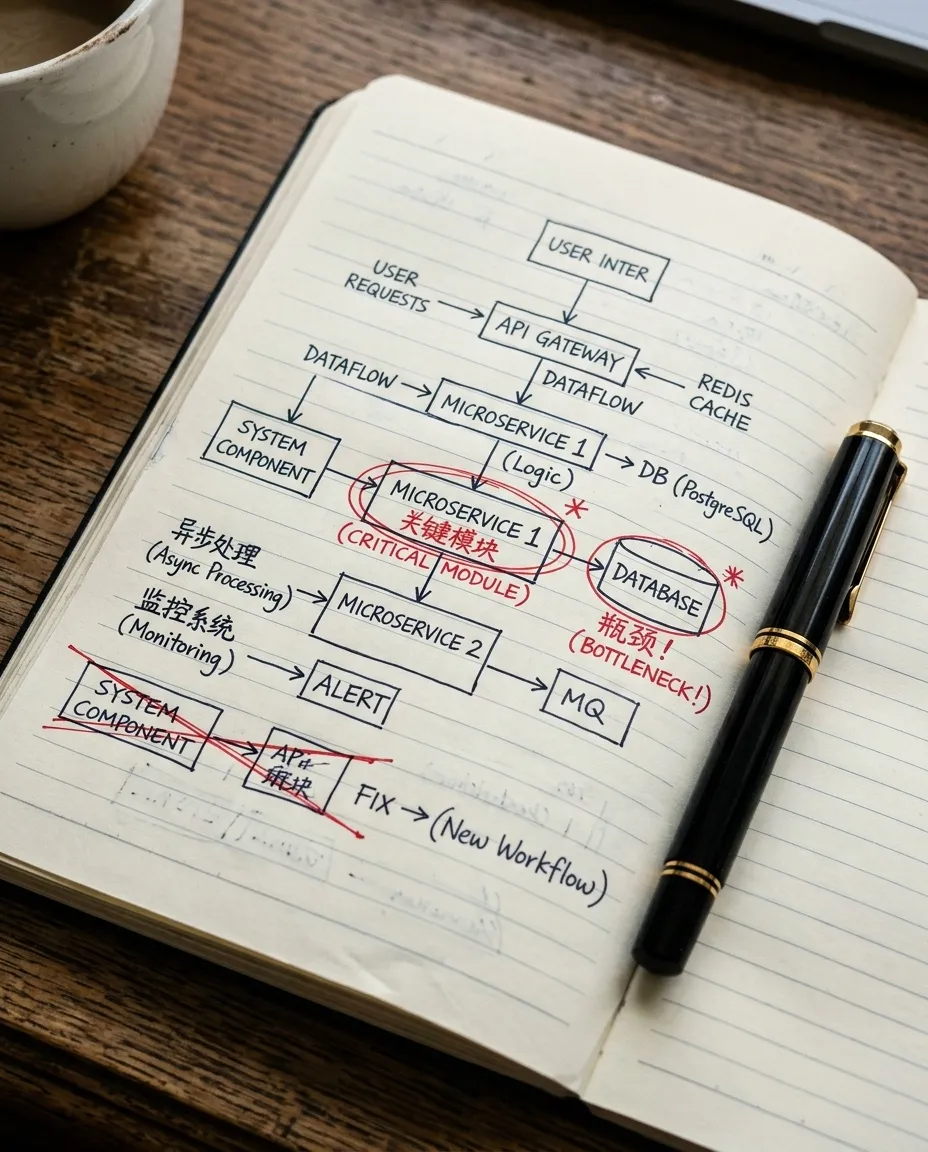
有一段时间我很得意于一件事:产线里所有模型的输出都是 JSON,一行代码就能解析,再也不用写正则从自然语言里抠字段了。
然后线上出了一个很难看的问题。某个环节的模型在大约 2% 的情况下会输出一个格式完全正确、字段齐全、但数值不合理的结果——比如一段音频的时长字段是 0,或者一个本该在 0 到 1 之间的分数是 37。
JSON 解析全部通过。下游拿着这些「合法」的数据往下跑,直到最后一步合成时才炸,而那时已经离真正出错的地方隔了四个环节。
能解析,不等于能用。 这件事让我重新想了「模型输出」到底是什么。
把模型当成一个不可信的外部服务
我最后的心智模型是:模型就是一个你不能读源码、行为会漂移、偶尔会一本正经地胡说的外部服务。你对待一个第三方接口会做的事,对模型输出全都要做,而且要做得更严。
具体就是三件:契约、校验、降级。
契约:不只是字段名,还有值域和关系
契约要写清楚的不只是「有哪些字段、什么类型」,还有:
- 值域:时长必须大于 0;分数必须在 0 到 1 之间;枚举只能是那几个值。
- 字段间关系:结束时间必须大于开始时间;片段数量必须等于列表长度。
- 和输入的关系:输出的时长不能超过输入音频的时长;输出的语言必须和请求的语言一致。
最后一类最容易漏,也最常出问题。模型对输入的理解偏了,输出在自己的世界里完全自洽,只有拿输入来对照才能发现。
校验:在离模型最近的地方,用代码而不是靠提示词
有了契约,校验的位置很重要——紧贴模型输出的下一行,而不是等下游用到的时候。越早拦住,定位越容易。
另一个原则:用代码校验,不要指望提示词。 我曾经在提示词里写了三遍「分数必须在 0 到 1 之间」,模型在 98% 的时候听话,剩下 2% 依旧我行我素。而这 2% 在批量产线里就是每天几十次。
提示词负责让好结果的概率变高,代码负责让坏结果一个都过不去。两者不能互相替代。
降级:校验不过之后,产线该怎么走
校验失败之后做什么,比校验本身更考验设计。我用的是一个三级策略:
- 重试一次,换一个措辞。很多时候只是模型这一次抽风,换个说法它就正常了。
- 换一个模型。同一个任务备一个不同来源的模型,主模型连续失败就切过去。两个模型同时抽风的概率很低。
- 标记并跳过,不要伪造。两个模型都不行,就把这个任务标记出来,人工看。绝对不要用一个「默认值」把坑填上继续跑——我早期这么干过,结果是产物看起来完整,实际上有一段是空白,直到有人真的看到最后才发现。
第三条我想多说一句。写兜底逻辑的时候,总有一种诱惑是「反正给个合理的默认值,别让流程断掉」。但一个被默认值悄悄填掉的错误,比一个大声报出来的错误贵十倍——前者会被带到很远的下游,混进产物里,直到有人用肉眼看到为止。
一个衡量标准
现在我判断产线里某个模型环节是否「接好了」,就看一件事:如果这个模型今天开始输出纯垃圾,产线会在哪一步停下来?
答案如果是「在它的下一行」,这个环节就接好了。答案如果是「最后合成的时候」或者「用户看到的时候」,那不管它平时表现多好,都还没接好。
SERVICES.waline即生效。想说话可以先去 留言板,那边我每条都回。